


Отказоустойчивый Bitrix-кластер: варианты инфраструктуры и особенности построения
Разбираем варианты отказоустойчивой инфраструктуры для Bitrix — от монолита до кластера
Построение отказоустойчивой инфраструктуры для проектов на Bitrix — задача, в которой необходимо учитывать большое количество факторов. Особенности работы Bitrix-ядра накладывают определённые ограничения на архитектуру, поэтому универсального варианта инфраструктуры, одинаково подходящего для всех проектов, не существует.
В этой статье разберём основные варианты Bitrix-инфраструктуры с разным уровнем отказоустойчивости: от классического монолита до сложных кластерных решений на базе Kubernetes.
Материал представляет собой теоретическую часть серии статей. Здесь рассмотрим особенности кластеризации, варианты архитектуры и основные нюансы Bitrix-составляющей.
Что такое кластер и отказоустойчивая инфраструктура
Кластер — это объединение нескольких вычислительных систем — виртуальных или физических серверов, — которые работают совместно для выполнения общих задач.Кластер позволяет:
1. Управлять несколькими серверами с помощью одного модуля управления.
2. Добавлять произвольное количество рабочих серверов без остановки системы.
3. Синхронизировать данные между серверами.
4. Распределять запросы по разным серверам.
5. Минимизировать время простоя в случае выхода из строя одного из серверов.
Отказоустойчивая инфраструктура — это кластер, построенный по методике обеспечения высокой доступности и гарантирующий минимальное время простоя в случае выхода из строя одного или нескольких узлов кластера — в зависимости от масштабов инфраструктуры.
Если взять за основу данные из Wikipedia, кластер характеризуется несколькими отличительными особенностями:
- Высокая доступность — наиболее распространённый уровень, ожидаемый пользователями. Система или приложение доступны в обозначенные требованиями дни и часы без незапланированных простоев, а о запланированных остановках сообщается заранее.
- Непрерывный режим работы (continuous operations) — система доступна 24 часа в сутки, 7 дней в неделю без запланированных простоев.
- Постоянная доступность (continuous availability) — сочетание высокой доступности с непрерывным режимом работы. Система доступна 24 часа в сутки, 7 дней в неделю без запланированных или незапланированных простоев.
Вычислительные машины в кластере чаще всего называют нодами. Например: первая нода MySQL, вторая нода PHP, третья нода Redis.
Основные варианты Bitrix-инфраструктуры
По нашему опыту, чаще всего встречаются четыре разновидности Bitrix-инфраструктуры с разным процентом отказоустойчивости:
- 1. Инфраструктура с 0% отказоустойчивости.
- 2. Инфраструктура с 70% отказоустойчивости.
- 3. Инфраструктура с 90% отказоустойчивости.
- 4. Инфраструктура с 95% отказоустойчивости.
Разберём каждый из вариантов отдельно.
Инфраструктура с 0% отказоустойчивости
У системных администраторов такую инфраструктуру называют Bitrix-монолитом.
Существует два основных варианта Bitrix-монолита:
1. BitrixVM.
В российском сегменте такой вариант встречается чаще всего. Примерно 80% проектов работают на данной инфраструктуре.
BitrixVM — это настроенное решение от компании 1С-Битрикс, работающее на базе CentOS Linux и использующее для настройки Ansible-роли. Оно включает необходимые для работы Bitrix сервисы и инструментарий для их настройки.
Плюсы BitrixVM:
- В тестах производительности в административной панели Bitrix можно получать очень высокие показатели скорости работы.
- Решение очень легко настраивается. Достаточно изучить доступные руководства и уметь пользоваться стрелками и цифрами на клавиатуре.
- Сложность администрирования. Чтобы разобраться в символьных ссылках BitrixVM, необходимо потратить достаточно много времени.
- Безопасность. Все сайты, которые находятся на сервере, работают от одного пользователя
bitrix. Кроме того, чаще всего пользователь Bitrix имеет праваsudo.Если будет взломан один сайт, потенциально будут взломаны все сайты, а злоумышленник может получить доступ кroot.
- Зависимости. Это становится проблемой, если необходимо удалить или переустановить один или несколько пакетов. При удалении пакета можно затронуть важный пакет или библиотеку из-за зависимостей со скриптами BitrixVM.
- Сложность обновления и переезда. Если необходимо мигрировать на другой сервер, можно потерять большое количество данных и настроек. В результате время переезда может существенно увеличиться: вместо стандартных 10–12 часов Bitrix-переезда оно может занимать 20–30 часов. Кроме того, если обновление прошло не по плану, решение от Bitrix не предусматривает возможности отката к предыдущей версии.
- Нулевая отказоустойчивость.Что это означает на практике? Любая крупная DDoS-атака может положить проект на долгие часы. При отказе сервера будет недоступен весь проект. Иными словами: Лёг сервер — лёг проект. Поэтому BitrixVM не рекомендуется использовать в инфраструктуре, где на одном сервере одновременно работают несколько сайтов.
2. Ручное развёртывание на Debian / Ubuntu / CentOS.
Альтернативой BitrixVM является ручное развёртывание Bitrix-проектов на Debian, Ubuntu или CentOS без установки BitrixVM.
При таком варианте инфраструктуры отсутствуют первые четыре рассмотренных выше недостатка BitrixVM:
- сложность администрирования;
- проблемы с безопасностью;
- большое количество зависимостей;
- сложности с обновлением и миграцией.
При этом ручное развёртывание требует больше времени на первоначальную установку и настройку программного обеспечения.
Однако в обоих вариантах — BitrixVM и ручном развёртывании — итог один: 0% отказоустойчивости.
Почему Bitrix-монолиты так популярны:
- 1. Простота развёртывания BitrixVM очень легко развернуть. Путём выбора нескольких пунктов меню можно быстро создать новый проект.
-
- 2. Низкая стоимость. Достаточно арендовать один сервер для работы всего проекта.
Кому подходит инфраструктура с 0% отказоустойчивости:
- Проектов, которые могут позволить себе простой продолжительностью от 2 до 12 часов.
- Порталов, которые представляют собой исключительно информационный ресурс.
- Новостных сайтов.
Инфраструктура с 0% отказоустойчивости не подходит для:
- Интернет-магазинов, поскольку простой проекта означает потерю клиентов.
- Проектов, посещаемость которых превышает 10 000 пользователей в день.
Инфраструктура с 70% отказоустойчивости
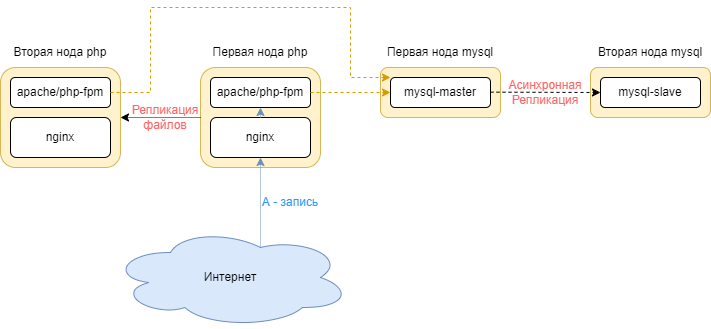
Следующий вариант встречается значительно реже. По личным наблюдениям, примерно 15% проектов на Bitrix используют подобную инфраструктуру.Она уже включает несколько серверов:
1. Ноды MySQL со slave-серверами.
2. Резервные серверы с кодом и резервными копиями.
Такой кластер уже является отказоустойчивым. В нём реализовано ручное переключение трафика на резервные серверы.
Например:
- если выходит из строя первая PHP-нода, можно переключить A-запись на вторую ноду;
- если выходит из строя первая MySQL-нода, можно переключить трафик на вторую MySQL-ноду.
Плюсы:
- Несколько рабочих копий проекта. Проект имеет несколько рабочих копий, синхронизированных между собой.
- Возможность быстрого восстановления. В случае выхода из строя основной ноды всегда остаётся вариант восстановления проекта в кратчайшие сроки.
- Горизонтальное масштабирование. Можно добавлять несколько нод того или иного сервиса — например, MySQL или PHP.
- Возможность распределять запросы MySQL. Если используется лицензия Bitrix, можно настроить кластер MySQL таким образом, чтобы запросы на запись направлялись на master, а запросы на чтение — на slave. Это позволяет ускорить работу проекта. Однако необходимо учитывать, что такая лицензия стоит от 1 000 000 рублей, поэтому позволить её себе может далеко не каждый проект.
- Горизонтальное масштабирование инфраструктуры. Архитектура позволяет постепенно увеличивать количество серверов по мере роста проекта.
Минусы:
- Ручное переключение трафика В случае выхода из строя основной ноды необходимо вручную изменить A-запись и адрес базы данных в коде Bitrix. Это может занимать определённое время. Например, если аварийное отключение ноды произойдёт ночью.
- Уязвимость к DDoS-атакам. Инфраструктура всё ещё уязвима для DDoS-атак. Мощная DDoS-атака может положить проект на несколько часов. В такой ситуации простое переключение A-записи не поможет.
Инфраструктура с 70% отказоустойчивости подходит для:
- Проектов, для которых простой продолжительностью один-два часа допустим.
- Проектов с посещаемостью от 10 000 до 100 000 пользователей в день.
- Небольших интернет-магазинов.
Инфраструктура с 70% отказоустойчивости не подходит для:
- Проектам, для которых простой на один-два часа недопустим.
- Проектам с посещаемостью свыше 100 000 пользователей в день.
Инфраструктура с 95% отказоустойчивости
Это практически идеальный и при этом крайне редко встречающийся вариант — Bitrix в Kubernetes с использованием CI/CD.
Такой вариант встречается крайне редко — менее чем в 1% случаев.
Инфраструктура строится на базе Kubernetes (k8s) с использованием Docker.
Почему такой вариант встречается крайне редко:
1. Высокая стоимость.
Построение подобной инфраструктуры требует существенных затрат.
При этом такие решения действительно способны выдерживать очень серьёзные нагрузки. Например, встречались ситуации, когда Bitrix-проект подвергался DDoS-атакам 24/7 и при этом продолжал работать.
2. Особенности работы Bitrix.
Главная проблема связана с тем, как Bitrix работает с изменениями.
Любое изменение страницы через административную панель Bitrix может привести к полной поломке проекта на стороне серверов, поскольку Bitrix изменяет не только код, но и базу данных.
Поэтому необходимо приучить разработчиков не использовать административную панель для подобных изменений, а вносить изменения в код через систему контроля версий, например Git.
На практике это не так просто, как может показаться.
Для перехода в Kubernetes подходят проекты:
1. Которые уже давно являются кастомными. Всё, что объединяет их с Bitrix, — это ядро Bitrix.
2. Которые уже давно не используют административную панель и вносят все изменения в код только через CI.
Такой вариант является наиболее отказоустойчивым и включает несколько уровней защиты от отказов:
- защиту от DDoS;
- отказоустойчивость базы данных;
- отказоустойчивость PHP-серверов.
Инфраструктура с 90% отказоустойчивости
Теперь вернёмся к более практичному варианту и рассмотрим инфраструктуру с 90% отказоустойчивости.Она включает:
1. Автоматическое переключение трафика при выходе из строя основных нод.
2. Несколько рабочих PHP- и MySQL-нод.
3. Отличную вертикальную масштабируемость.
Для построения такой архитектуры необходимо реализовать четыре основных компонента:
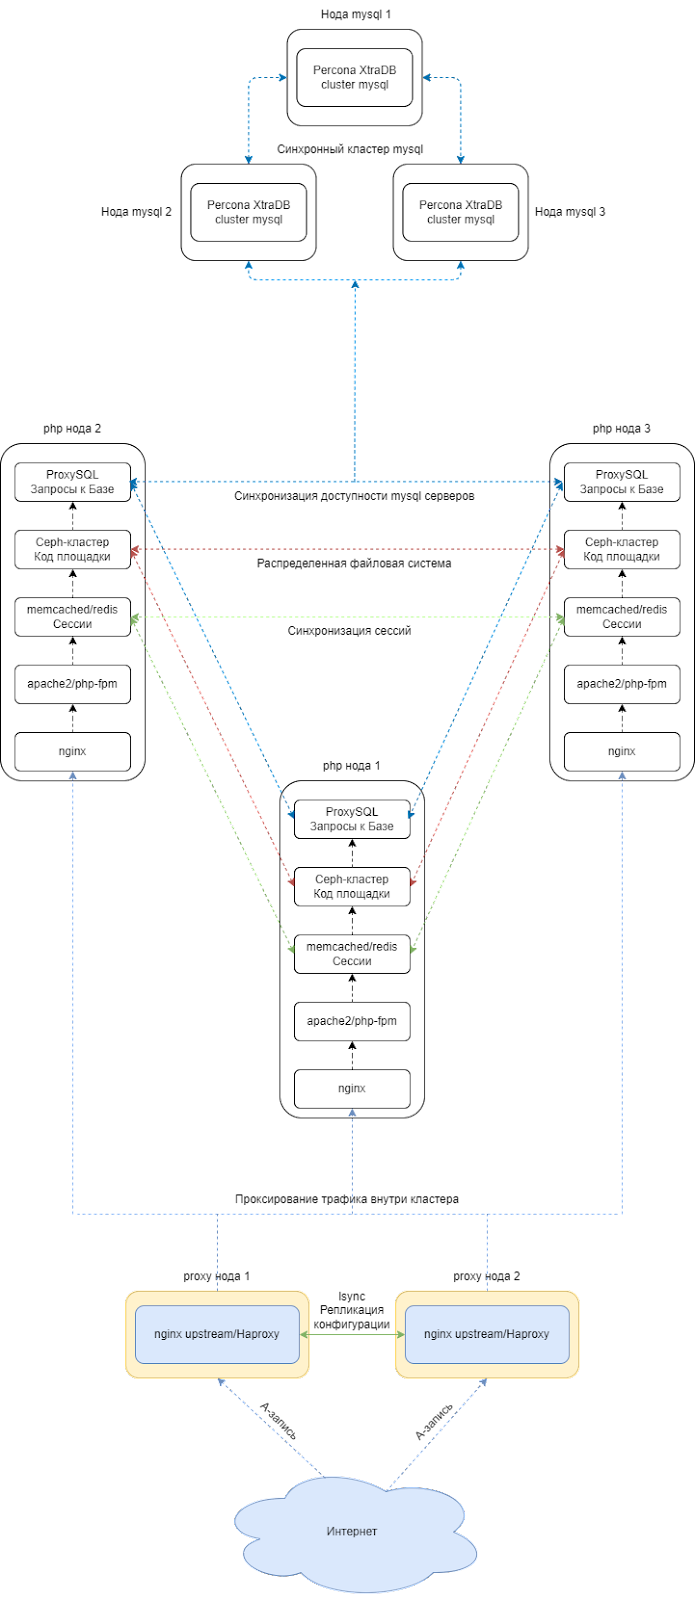
1. Распределённая файловая система Нужна распределённая файловая система для кода Bitrix, чтобы любое изменение в коде проекта сразу фиксировалось на нескольких серверах.
2. Синхронная репликация MySQL Необходима синхронная репликация MySQL для распределения запросов и автоматического переключения трафика между MySQL-серверами.
3. Проксирование трафика Необходимо проксирование трафика для переключения запросов между серверами при выходе из строя одной из нод.
4. Проксирование MySQL-трафика Необходимо проксирование MySQL-трафика для автоматического переключения запросов к базе данных между серверами в случае выхода из строя одной из нод.
Для достижения этих целей можно использовать следующие решения:
- Для первой цели можно использовать Ceph или GlusterFS. Bitrix активно работает с файлами, и при их расхождении между серверами могут возникать ошибки и критические последствия. Поэтому необходимо обеспечить актуальность файлов на всех серверах. lsyncd не подходит из-за возможных задержек синхронизации.
-
Для второй цели рекомендуем Percona XtraDB Cluster. Это удобный в администрировании MySQL-кластер с автоматическим восстановлением репликации и удобным Dashboard.
-
Для третьей цели подойдут Nginx Upstream, HAProxy или Network Load Balancer. Они позволяют отслеживать состояние PHP-нод и управлять трафиком внутри кластера.
-
Для четвёртой цели рекомендуем ProxySQL. Он позволяет управлять трафиком между MySQL-серверами, настроить резервирование и обойти ограничение Bitrix, связанное с кластеризацией MySQL.
Схема инфраструктуры
На данный момент существует несколько вариантов построения данной инфраструктуры. Основное отличие заключается во входной точке в кластер.
Вариант 1. Proxy-серверы.
На входе используются proxy-серверы с nginx upstream или HAProxy.
В этом случае в инфраструктуру добавляются ещё два сервера. Стоимость их аренды будет относительно невысокой, поскольку для этих серверов не требуются большие вычислительные мощности.
При этом увеличивается количество серверов, которыми необходимо управлять, а значит, возрастает нагрузка на системных администраторов.
В данном варианте A-запись указывает сразу на два сервера, после чего proxy-ноды распределяют трафик по кластеру.
Вариант 2. Network Load Balancer
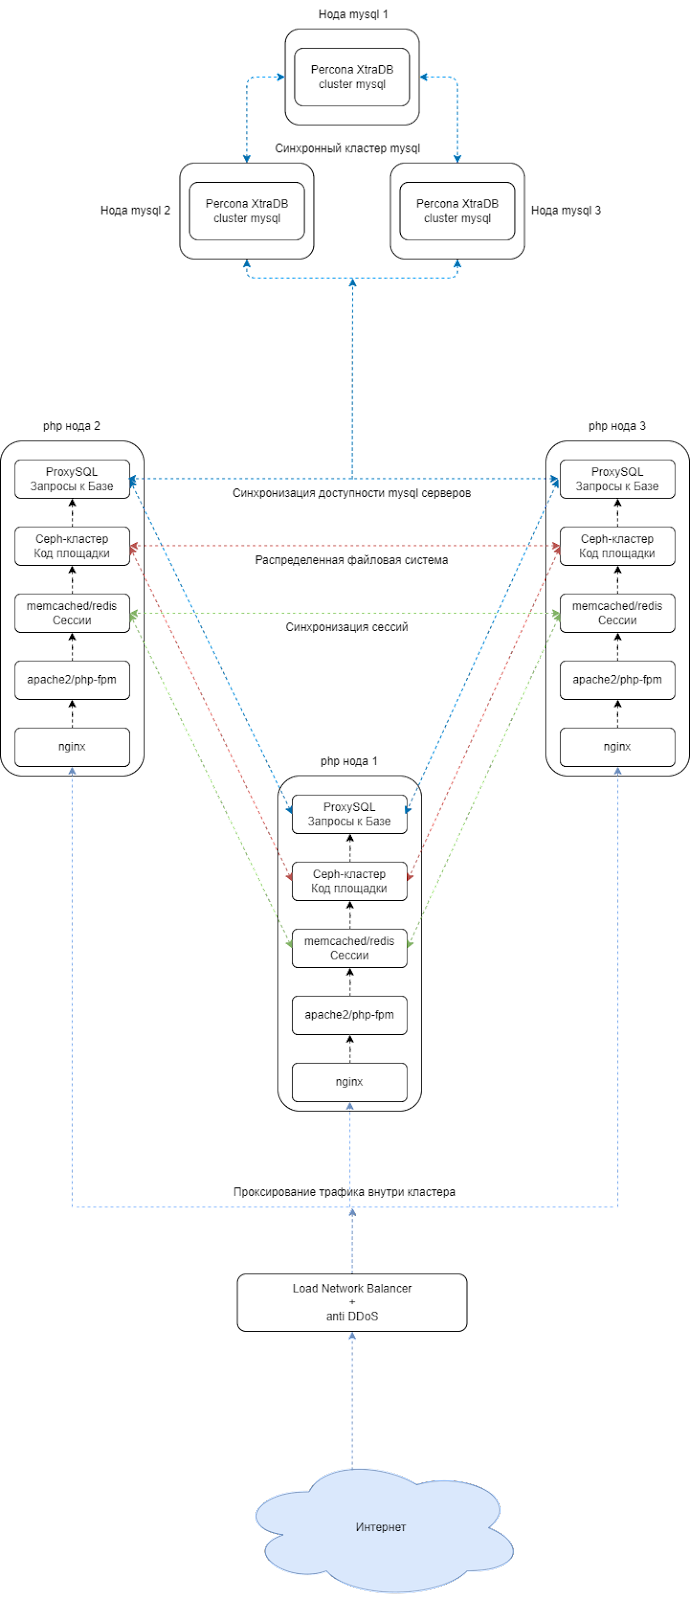
Более предпочтительным вариантом является использование Network Load Balancer.
По себестоимости такой вариант будет сопоставим с предыдущим, однако нагрузка на системных администраторов будет несколько ниже.
Основное преимущество такого решения — отсутствие дополнительных серверов, за которыми необходимо постоянно следить.
Особенности инфраструктуры
В этой инфраструктуре можно менять количество серверов. Главное - это иметь нечетное количество серверов mysql и php с ceph. Зачем это необходимо? Это необходимо для того, чтобы не было рассинхронизации данных в связи с проблемами в сети.
Например, в случае проблем с сетью две ноды mysql будут считать себя главными и будут считать свои данные самыми актуальными. Когда сеть восстановится, будут проблемы и ошибки в данных, что приведет к проблемам работы проекта. Для устранения этой проблемы всегда необходимо использовать нечетное количество серверов.
Для отслеживания конфигурации сервисов на всех серверах можно использовать:
- lsync-репликацию.
- Управление серверами с помощью систем автоматизации (например, Ansible).
- Использовать систему контроля версий Git.
В этом кластере удобно управлять серверами. Если необходимо провести работы на одной из нод, просто отключаете ее из проксирования и проводите свои работы. Также удобно добавлять новые ноды в кластер, если ваш проект вырос, и ему требуется дополнения вычислительной мощности.
Как работает кластер
Трафик идет по А-записи на Load Balancer. В данном случае Load Balancer является точкой входа в кластер.
В Load Balancer трафик фильтруется с помощью встроенной защиты от DDoS, после чего легитимный трафик попадает в кластер. Load Balancer будет самостоятельно фильтровать трафик по нодам. Схему данной инфраструктуры можно масштабировать увеличивая количество нод.
Варианты фильтрации трафика на трех нодах?
1. 50%/50%/0%.
Трафик будет идти на две ноды, а третью ноду можно использовать для cron задач или как запасной сервер для случая когда идет активная DDoS атаки или в связи с возросшим трафиков из-за распродажи.
2. 33%/33%/33%.
Трафик идет на три ноды одинаково.
3. 100%/0%/0%
Трафик идет только на одну ноду. Другие ноды будут резервные, либо ноды для тестирования конфигурации.
Что происходит при отказе PHP-ноды
Рассмотрим ситуацию, когда в кластере выходит из строя PHP-нода №1.
После получения от ноды 5–10 ошибок — в зависимости от настроек — Load Balancer исключает её из проксирования и помечает как недоступную.
После этого весь трафик направляется только на рабочие ноды.
В результате пользователи не заметят простоя.
Как проверяется доступность PHP-ноды
Load Balancer отправляет запросы на порт 80 каждой ноды.
Если он не получает определённое количество ответов, нода помечается как нерабочая и исключается из проксирования.
Что происходит при отказе MySQL-ноды
В случае выхода из строя MySQL-ноды ProxySQL помечает её как нерабочую и перенаправляет запросы на другие ноды.
Даже при выходе из строя двух MySQL-нод проект не должен потерять работоспособность и продолжит работать.
Кому подходит данный кластер с 90% отказоустойчивости:
- Проекты с большой аудиторией. От 100 000 пользователей в день.
- Большие интернет-магазины.
- Все те, для кого простой площадок и сервисов неприемлем.
Кому не подходит данный кластер?
- Маленькие проекты. Данный кластер будет для них избыточен, а также нерентабелен ввиду высокой стоимости инфраструктуры проекта.
Плюсы:
- Высокий процент отказоустойчивости на различных уровнях.
- В случае выхода из строя нескольких нод проект продолжит работать без простоя, даже под нагрузкой.
- Легко масштабируется. Необходимо добавить диск или оперативной памяти? Просто отключаете сервер из проксирования и выполняете работы по замене.
Минусы:
- Высокий уровень знаний для входа, так как мало кластер развернуть - его еще необходимо администрировать, поддерживать, мониторить и настраивать.
- Данный вариант инфраструктуры очень чувствителен к ширине канала сети в Дата-центре, и потребует высокого производительных сетевых интерфейсов, т.к. Ceph и Percona XtraDB cluster очень зависит от скорости и качества работы сети.
Итоги
В этой статье мы рассмотрели различные варианты отказоустойчивой инфраструктуры для Bitrix — от классического монолита до сложного кластера с несколькими уровнями защиты.
В зависимости от требований проекта можно использовать:
- 0% отказоустойчивости — Bitrix-монолит на одном сервере;
- 70% отказоустойчивости — несколько серверов с резервными нодами и ручным переключением трафика;
- 90% отказоустойчивости — полноценный кластер с автоматическим переключением трафика, несколькими PHP- и MySQL-нодами, распределённой файловой системой, синхронной репликацией и проксированием;
- 95% отказоустойчивости — инфраструктура на Kubernetes с Docker и CI/CD.
Какой вариант подходит конкретному проекту, зависит от того, какие задачи необходимо решить и какой уровень простоя допустим.
Безусловно, всем хотелось бы иметь инфраструктуру с 95% отказоустойчивости. Однако построение такой схемы требует значительных капитальных вложений, а также больших усилий для настройки и дальнейшего сопровождения.
При выборе архитектуры необходимо учитывать не только технические возможности, но и экономическую целесообразность.
Минимизация простоя сайта и обеспечение его стабильной работы на протяжении всего периода эксплуатации имеют критическое значение для бизнеса.
В следующей статье можно перейти от теории к практике и рассмотреть пример настройки кластера с 90% отказоустойчивостью, включая основные нюансы и подводные камни такого решения.
Похожие статьи
Как защитить CI/CD-пайплайн: основные практики DevSecOps
Основные проблемы безопасности CI/CD и передовые стратегии предотвращения возможных угроз
Система для сборки и тестирования ПО в разработке игр: облако, железо или гибрид?
Технический руководитель НИКСИС Пётр Рукин рассказал, как команда построила собственную систему серверов и компьютеров для сборки и тестирования ПО
Оставьте заявку, чтобы обсудить проект
 MAX
Спасибо за обращение
Мы свяжемся с вами в ближайшее время.